
베이지안 사고 사전확률 설정 방법의 핵심은 기준률 확인 → 정보의 질 평가 → 확률이나 분포로 표현 → 사전예측 점검 → 민감도 분석의 순서로 생각하는 것이다. 사전확률은 막연한 감을 숫자로 꾸미는 장치가 아니다. 새로운 증거를 보기 전에 이용할 수 있었던 과거 자료와 배경지식, 현실적 제약을 공개적으로 정리한 출발점이다.
예를 들어 한 팀이 새 프로젝트의 성공 가능성을 판단한다고 하자. 담당자는 긍정적인 고객 반응을 보고 성공을 확신할 수 있지만, 비슷한 프로젝트의 과거 성공률이 10%였다면 그 기준률을 먼저 고려해야 한다. 같은 반응도 출발점이 10%인지 50%인지에 따라 업데이트된 결론이 달라진다. 베이지안 사고는 이런 차이를 숨기지 않고 계산과 토론의 대상으로 만든다.
사전확률은 새로운 증거 이전의 불확실성이다
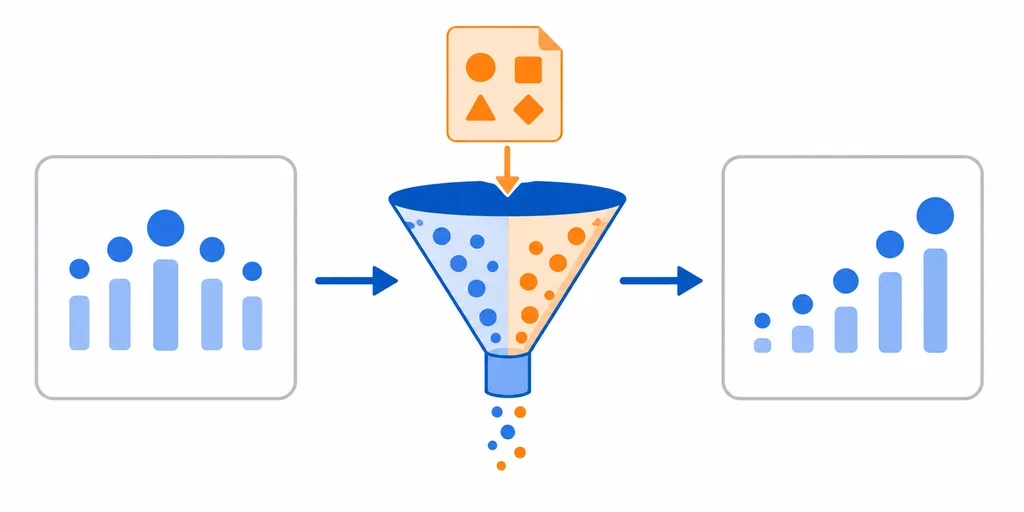
사전확률 뜻을 가장 간단히 말하면 ‘현재 증거를 반영하기 전에 가설이 맞을 가능성’이다. 가설이 둘이면 각각의 확률로 나타낼 수 있다. 매출 증가율이나 불량률처럼 값이 연속적이면 하나의 숫자보다 가능한 값과 그 불확실성을 담은 사전분포로 표현한다.
사전확률·가능도·사후확률의 차이
사전확률은 출발점이고, 가능도는 특정 가설이 참일 때 지금 관측한 증거가 얼마나 예상되는지를 나타낸다. 사후확률은 둘을 결합해 증거를 본 뒤 다시 계산한 확률이다. 관계는 다음처럼 요약할 수 있다.
사후분포 ∝ 가능도 × 사전분포
여기서 사전분포는 관측 전 불확실성, 가능도는 가정한 모수나 가설 아래에서 데이터가 나타날 가능성, 사후분포는 관측 후 갱신된 불확실성이다. 정규화 과정까지 포함하면 전체 확률의 합이 1이 된다. 이 구분과 결합 원리는 NIST의 베이지안 분석 설명에서도 확인할 수 있다.
과거 데이터가 있어도 사전정보가 될 수 있다
사전이라는 말은 데이터가 전혀 없다는 뜻이 아니다. 이번 분석 대상의 새로운 데이터를 보기 전이라는 뜻에 가깝다. 이전 분기의 전환율, 유사 제품의 고장률, 동종 프로젝트의 성공률, 전문가가 아는 작동 원리, 음수가 될 수 없다는 물리적 제약도 사전정보가 된다. 다만 현재 데이터의 일부를 사전분포에도 넣고 가능도에도 다시 쓰면 같은 증거를 두 번 반영하게 되므로 정보의 시점을 구분해야 한다.
왜 기준률에서 시작해야 할까
눈에 띄는 증거는 판단을 쉽게 지배한다. 그러나 드문 사건은 꽤 정확해 보이는 신호가 나와도 실제일 확률이 기대보다 낮을 수 있다. 이는 신호가 쓸모없어서가 아니라 사건 자체가 드물다는 기준률이 계산에 들어가기 때문이다. 따라서 ‘증거가 강해 보이는가?’와 함께 ‘증거를 보기 전에는 얼마나 흔한가?’를 물어야 한다.
사전정보의 영향은 데이터가 적거나 잡음이 많을 때 특히 커진다. 반대로 관측이 충분하고 데이터가 강하면 여러 합리적 사전분포에서 비슷한 사후결과가 나올 수 있다. 중요한 질문은 사전분포가 결과에 영향을 주느냐가 아니라, 그 영향이 근거와 목적에 비추어 타당하고 투명하냐는 것이다.
베이지안 사고 사전확률 설정 방법 5단계
1. 문제와 가설의 범위를 먼저 고정한다
‘프로젝트가 성공할까?’처럼 모호한 질문은 확률도 모호하게 만든다. 성공을 출시 6개월 안에 손익분기 달성으로 정의하고, 대상 시장과 기간을 명시한다. 서로 겹치지 않는 가설인지, 빠진 선택지는 없는지도 확인한다. 예측 대상과 시간 범위가 달라지면 참고해야 할 기준률도 달라진다.
2. 가장 가까운 기준률과 과거 데이터를 찾는다
먼저 넓은 모집단의 기준률을 보고, 분석 대상과 비교 가능한 조건으로 좁힌다. 산업 전체 평균보다 같은 제품군·가격대·유통 방식의 기록이 더 적합할 수 있다. 표본 수, 측정 방식, 관측 시점이 현재 문제와 맞는지 확인하고 오래되거나 선택 편향이 큰 자료에는 낮은 가중치를 둔다. 유사 사례가 여러 묶음이면 하나만 골라 확신하기보다 범위를 기록한다.
3. 전문가 판단과 확인 가능한 지식을 분리한다
전문가는 데이터에 없는 맥락을 제공하지만 자신감이 정확성을 보장하지는 않는다. ‘가능성이 높다’는 표현 대신 최솟값·가장 그럴듯한 값·최댓값을 각각 묻고, 왜 그렇게 판단했는지 근거를 적는다. 여러 전문가에게 독립적으로 답을 받은 뒤 차이가 나는 이유를 비교하면 권위나 집단 동조의 영향을 줄일 수 있다. 주관성을 없애려 하기보다 누가 어떤 정보로 판단했는지 추적 가능하게 만드는 편이 현실적이다.
4. 단일 숫자보다 범위와 분포로 표현한다
이진 가설은 ‘성공 20%, 실패 80%’처럼 시작할 수 있다. 연속형 값은 중심과 퍼짐을 함께 정한다. 예를 들어 전환율의 중심을 5%로 보더라도 4~6%에 거의 확신하는지, 1~12%도 가능하다고 보는지는 전혀 다른 사전분포다. 표본이 작거나 근거가 약하면 지나치게 좁은 분포를 피하되, 단순히 매우 넓게 만들면 중립적이라는 생각도 경계해야 한다. 모형의 척도와 변환 방식에 따라 넓은 분포가 비현실적인 값에 큰 확률을 줄 수 있다.
5. 가상 결과와 대안 사전을 비교한다
사전예측 점검은 정한 사전분포에서 모수를 뽑고 데이터 모형으로 가상 관측값을 만들어, 분석 전에 어떤 결과가 나올 수 있다고 가정했는지 확인하는 절차다. 음수 매출, 불가능한 비율, 현실을 벗어난 극단값이 자주 생성된다면 분포의 위치나 폭, 모형을 다시 살핀다. 구체적인 원리는 Stan 사용 안내서의 예측 점검 설명을 참고할 수 있다.
그다음 보수적·중간·낙관적이지만 모두 설명 가능한 사전을 적용해 결론이 얼마나 달라지는지 본다. 이것이 민감도 분석이다. 의사결정이 작은 변경에도 뒤집히면 ‘성공 확률 37%’처럼 한 숫자를 강조하기보다 사전 가정에 민감하다고 보고해야 한다.
가상의 숫자로 이해하는 베이지안 업데이트
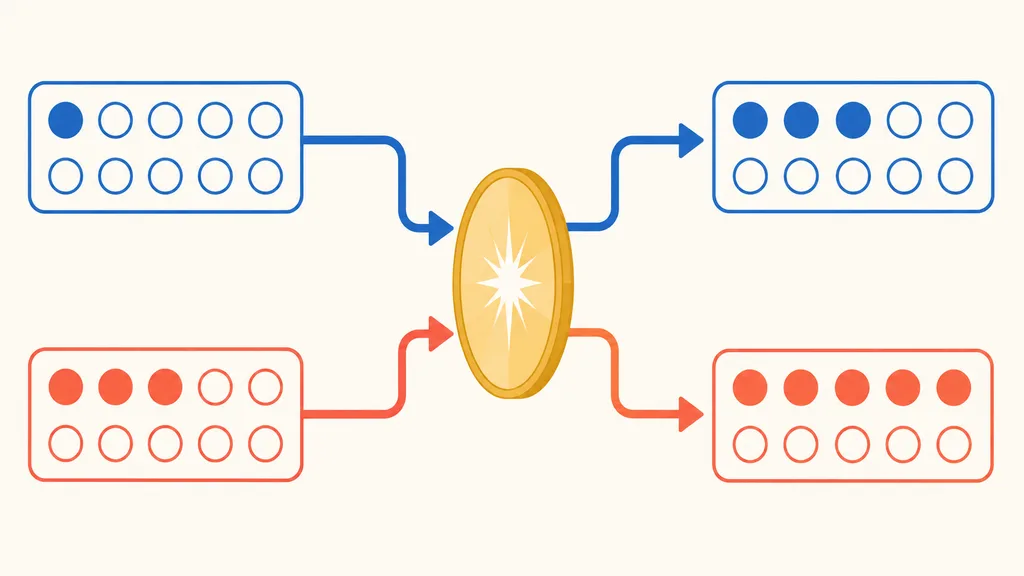
다음은 원리 이해를 위한 가상의 예시이며 실제 사업 성과나 연구 통계가 아니다. 과거 유사 프로젝트 100개 중 10개가 성공했다면 성공의 사전확률을 10%로 둔다. 한 사전 테스트에서 긍정 신호가 나왔다고 하자. 성공 프로젝트에서는 긍정 신호가 나올 확률이 80%, 실패 프로젝트에서는 20%라고 가정한다.
100개를 상상하면 성공 10개 중 8개에서 긍정 신호가 나온다. 실패 90개 중에서는 18개가 긍정이다. 따라서 긍정 신호 26개 가운데 실제 성공은 8개이고, 업데이트된 성공 확률은 8 ÷ 26 ≈ 30.8%다. 신호를 본 뒤 확률은 10%에서 약 30.8%로 올랐지만 80%가 되지는 않는다. 80%는 ‘성공했을 때 긍정 신호가 날 확률’이지 ‘긍정 신호가 났을 때 성공할 확률’이 아니기 때문이다.
같은 신호 조건에서 사전확률을 30%로 두면 성공 30개 중 긍정 24개, 실패 70개 중 긍정 14개다. 사후확률은 24 ÷ 38 ≈ 63.2%가 된다. 증거는 동일하지만 출발점에 따라 30.8%와 63.2%라는 다른 결과가 나온다. 어느 사전이 옳은지는 숫자의 모양이 아니라 참조 집단과 근거가 현재 문제에 얼마나 맞는지로 판단해야 한다.
설정할 때 자주 빠지는 네 가지 함정
- 무조건 50 대 50에서 시작하기: 정보가 부족하다는 이유만으로 두 가설을 같은 확률로 두면 실제 기준률을 지울 수 있다. 50%도 하나의 강한 가정이다.
- 넓은 분포를 완전히 객관적이라고 보기: ‘비정보적’ 또는 약한 정보성이라는 이름만으로 중립성이 보장되지 않는다. 허용 범위와 척도에 따라 결과가 달라진다.
- 근거보다 확신을 좁게 표현하기: 전문가의 최선 추정치 주변에 확률을 과도하게 몰아주면 소량의 새 데이터가 거의 반영되지 않을 수 있다.
- 정보를 중복 사용하기: 현재 고객조사 결과로 사전을 만들고 같은 조사 결과를 가능도에 다시 넣으면 증거가 부풀려진다.
여기에 사후확률을 인과관계의 증명으로 해석하는 오류도 주의해야 한다. 업데이트는 정한 가설, 데이터 모형, 사전정보 안에서 불확실성을 다시 계산할 뿐이다. 누락 변수나 잘못된 측정, 부적절한 비교집단을 자동으로 해결하지 않는다.
계산 없이도 쓰는 의사결정 습관
정교한 통계 프로그램이 없어도 베이지안 사고는 쓸 수 있다. 중요한 소식을 들었을 때 곧바로 찬반 결론을 내리는 대신, 먼저 비슷한 일이 평소 얼마나 자주 생기는지 적는다. 이어서 그 소식이 가설이 맞을 때와 틀릴 때 각각 얼마나 자연스러운지 비교한다. 증거가 어느 쪽에서도 흔하다면 업데이트 폭은 작아야 하고, 한쪽에서만 훨씬 예상된다면 크게 조정할 수 있다.
팀 회의에서는 최초 추정치와 수정 이유를 함께 남기는 것이 좋다. ‘20%에서 시작했으나 계약 의향을 확인해 35%로 올림’처럼 기록하면 결과만 공유할 때보다 판단을 검토하기 쉽다. 다음 데이터가 들어오면 현재 사후확률을 다음 판단의 사전확률로 사용할 수 있지만, 환경이나 대상 집단이 달라졌다면 그대로 넘기지 말고 다시 조정한다.
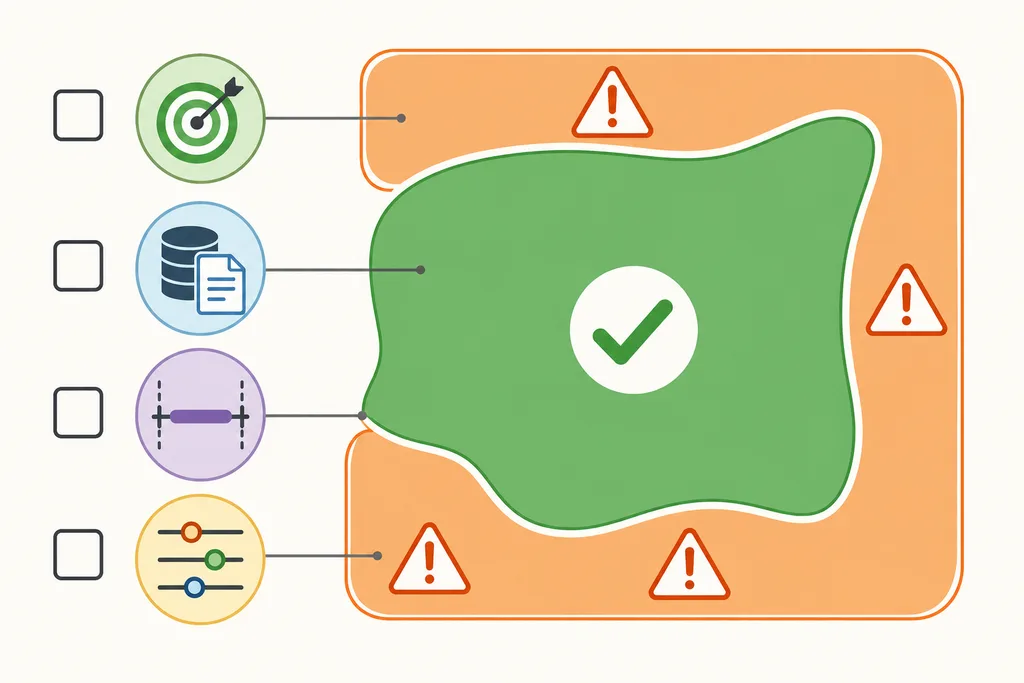
마지막으로 확인할 5단계 체크리스트
- 정의: 가설, 대상, 기간, 성공 조건을 구체적으로 정했는가?
- 기준률: 가장 유사한 참조 집단의 과거 자료를 확인했는가?
- 근거: 데이터, 전문가 판단, 현실적 제약의 출처와 시점을 분리했는가?
- 표현: 확신보다 좁은 분포를 피하고 가능한 범위까지 나타냈는가?
- 검증: 사전예측 점검과 여러 합리적 사전을 이용한 민감도 분석을 했는가?
좋은 사전확률은 누구나 동의하는 정답이 아니라, 반박하고 수정할 수 있는 투명한 출발점이다. 기준률과 근거를 공개하고, 새로운 증거가 들어올 때 일관된 방식으로 베이지안 업데이트를 하며, 결론이 가정에 얼마나 민감한지 함께 제시하자. 그러면 사전확률은 주관성을 숨기는 숫자가 아니라 더 나은 질문과 책임 있는 의사결정을 돕는 도구가 된다.
